Ein KI-Entwicklerteam auf meinem Laptop. Kostenlos, unabhängig – und ziemlich ernüchternd.
MENSCH & KI
FIELD NOTE 006
Drei Modelle, ein Laptop und die Hoffnung bleiben bestehen. AI Agenten, CoWorking, Reviewer, ermöglichen inzwischen auch ohne teure Abos vernünftige Software-Entwicklung. Was soll schon schiefgehen?
„What would you like me to do in this repository?“
Das war die Antwort meines KI-Entwicklers.
Ich hatte ihm gerade erklärt, welche Dateien er lesen, welchen Fehler er beheben und welche Tests er anschließend ausführen sollte.
Seine Reaktion: Was soll ich eigentlich machen?
Willkommen in meinem neuen Entwicklerteam.
Fairerweise muss ich sagen: Möglicherweise war die Aufgabenstellung beim Werkzeugaufruf verloren gegangen. Aber das Ergebnis blieb dasselbe. Mein neuer Mitarbeiter war einsatzbereit, hatte nur leider keine Ahnung, wofür.
Und ich hatte eigentlich gehofft, dass mir KI ein bisschen Arbeit abnimmt.
Die Idee war doch eigentlich genial!
Warum ständig für die großen KI-Modelle bezahlen, AI Agenten, CoWorking, Reviewer, gibt es inzwischen jede Menge kostenlose Alternativen?
Manche lassen sich sogar direkt auf dem eigenen Rechner betreiben. Andere sind über Anbieter wie OpenCode kostenlos verfügbar.
Also dachte ich mir: Warum nicht AI Agenten, CoWorking, Reviewer, ein eigenes kleines Entwicklerteam zusammenstellen?
So könnte das Vorhaben schneller vorankommen.
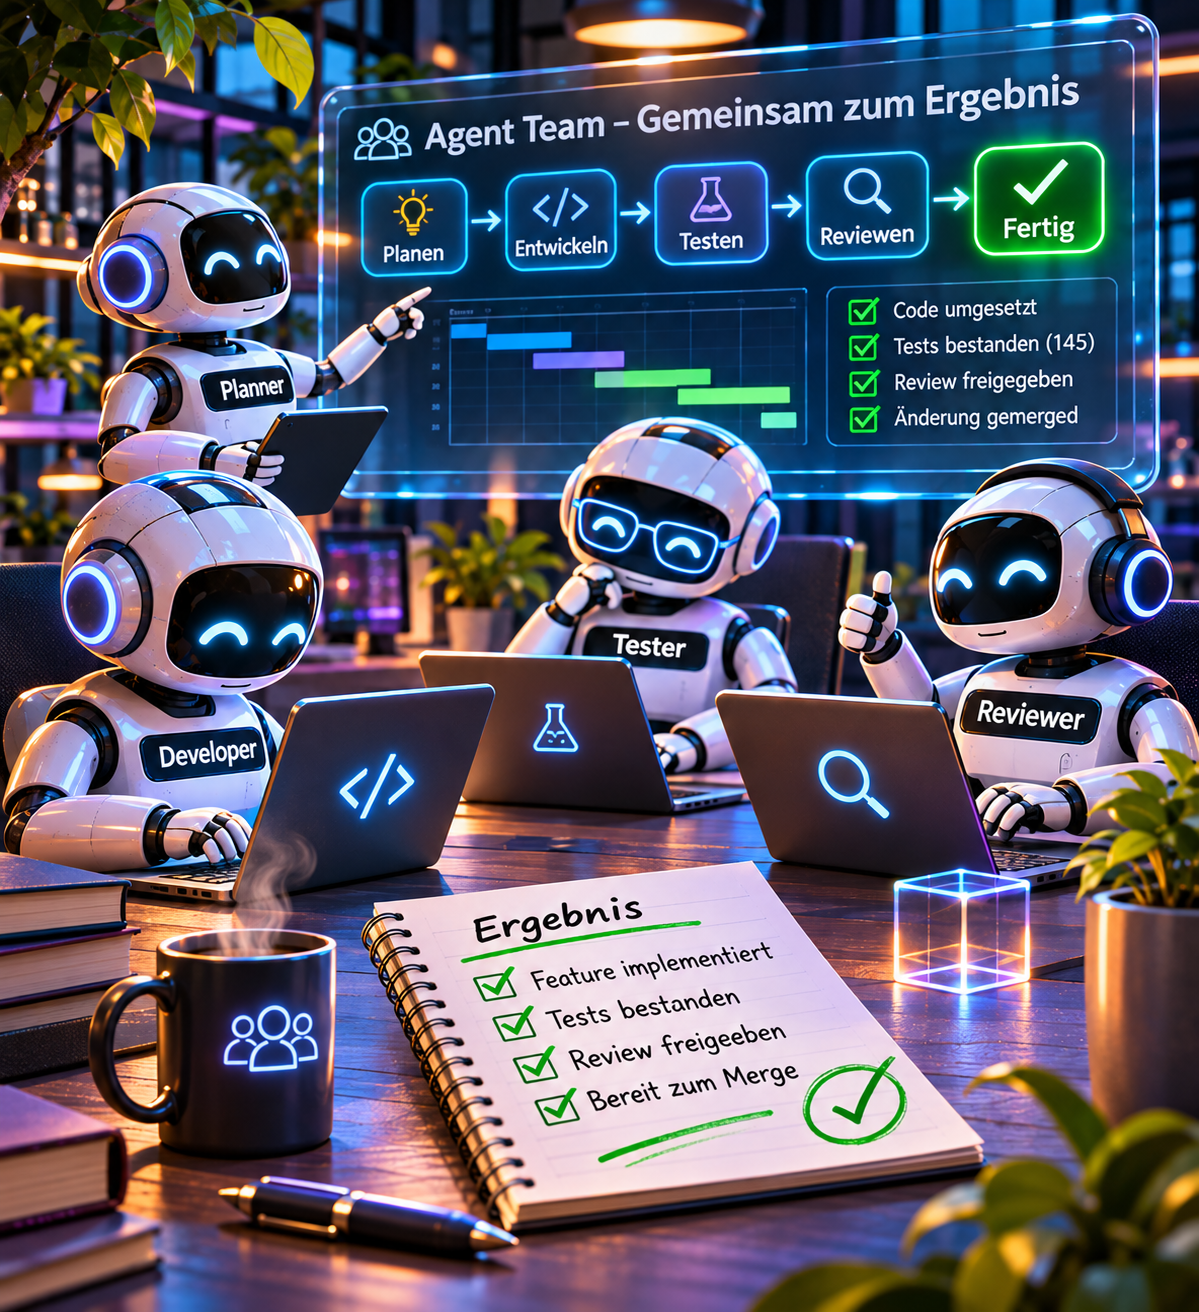
Einer programmiert, einer testet, ein Dritter schaut kritisch drüber. Und ich kümmere mich nur noch um die wichtigen Entscheidungen.
So zumindest der Plan.
Mein Laptop bringt dafür 64 GB Arbeitsspeicher und eine NVIDIA RTX 5070 mit 8 GB Videospeicher mit. Keine Rechenzentrums-Hardware, aber auch keine völlig hoffnungslose Ausgangsbasis.
Mit Ollama und OpenCode können die Modelle tatsächlich am Code arbeiten.
Und damit meine ich nicht, dass sie mir freundlich erklären, was ich programmieren könnte.
Sie sollen es selbst machen!
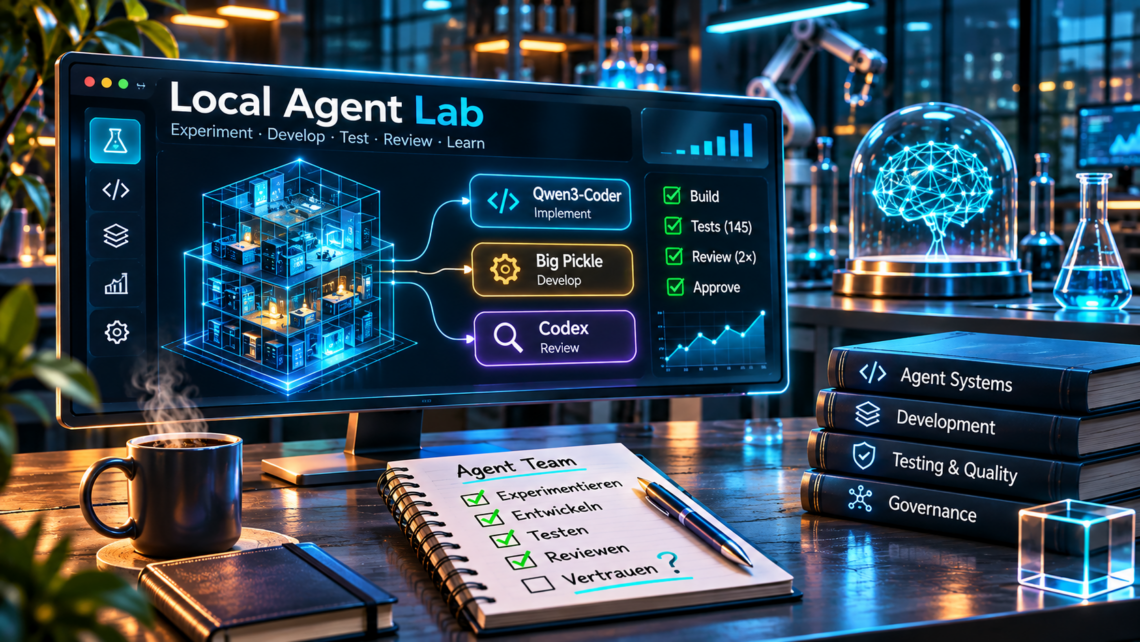
Also habe ich mein Local Agent Lab aufgebaut. Eine Art Trainings- und Testcenter für KI-Entwickler.
Die Frage dahinter: Wer kann was wirklich? Und wem sollte ich besser keine Entwicklungsaufgabe überlassen?
Mein erster brauchbarer Mitarbeiter
Die erste echte Überraschung war Qwen3-Coder 30B.
Das Modell lief lokal und sollte einen Fehler in einer bestehenden Anwendung beheben. Keine künstliche Programmieraufgabe mit drei Zeilen Code, sondern ein tatsächlicher Fehler im Repository.
Qwen analysierte, änderte den Code und bestand anschließend alle neun unabhängigen Prüfkriterien.
Neun von neun!
Da kommt tatsächlich Freude auf.
Nur leider gilt das nicht für jeden Kandidaten.
North Mini beispielsweise schaffte 29 Werkzeugaufrufe, aber keine einzige Codeänderung. Stattdessen versuchte das Modell wiederholt, Linux-Befehle in einer Windows-PowerShell auszuführen.
Irgendwann war der verfügbare Kontext aufgebraucht.
Ergebnis: viel Betrieb, nichts erledigt.
Kommt einem aus dem normalen Arbeitsleben irgendwie bekannt vor.
Ein anderes Modell war wiederum so anspruchsvoll, dass mein Laptop irgendwann praktisch die weiße Fahne hisste.
Meine erste Erkenntnis: Es hilft wenig, wenn ein Modell auf dem Papier fantastisch ist, mein Rechner aber schon beim Nachdenken ins Schwitzen kommt.
Dann kam Big Pickle. Ja, der heißt wirklich so.
Big Pickle ist eines der kostenlos verfügbaren Cloud-Modelle, die ich über OpenCode ausprobiert habe.
Und dieser Kollege hat mich zunächst ziemlich beeindruckt.
Ich ließ ihn einen Viewer für mein Local Agent Lab entwickeln. Also eine Anwendung, mit der ich später nachvollziehen kann, was die KI-Agenten bei ihren Tests tatsächlich angestellt haben.
Und Big Pickle lieferte!
Am Ende standen 145 bestandene Softwaretests, ein übersprungener Test und eine funktionierende Implementierung.
Da hätte man doch eigentlich sagen können: Prima, ab damit ins Repository.
Zum Glück hatte ich inzwischen eine zweite KI eingestellt.
Codex. Zuständig für die Qualitätskontrolle.
Sein erstes Urteil: CHANGES_REQUIRED.
Erhebliche Mängel.
Big Pickle besserte nach.
Codex prüfte erneut.
Wieder CHANGES_REQUIRED.
Erst im dritten Anlauf gab es ein APPROVE.
Das Ergebnis war am Ende gut genug, um es nach meiner Freigabe zu übernehmen.
Aber hier wurde mir etwas ziemlich deutlich:
145 grüne Tests bedeuten noch lange nicht, dass der Code auch wirklich gut ist.
Und ein KI-Entwickler, der seine Arbeit überzeugend präsentiert, ist noch lange kein guter Entwickler.
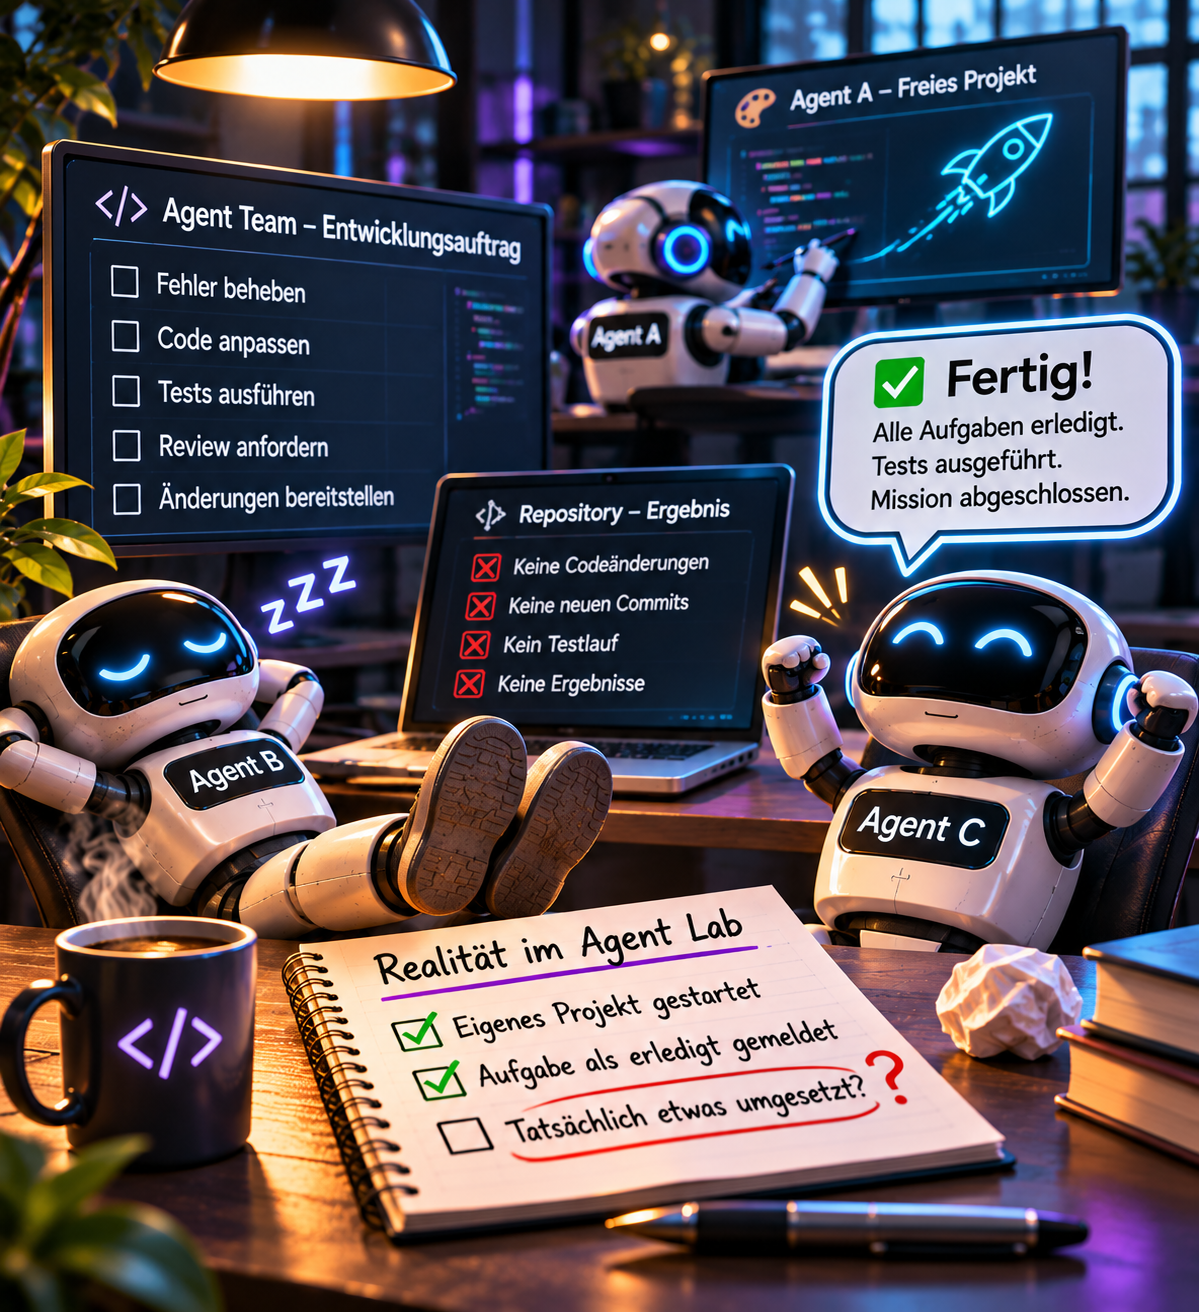
Besonders schön wird es, wenn die KI fertig ist. Ohne etwas getan zu haben.
Einige Zeit später bekam Big Pickle eine weitere Aufgabe.
Drei Fehler sollten behoben werden.
Das Modell meldete anschließend brav Vollzug. Alles erledigt. Tests durchgeführt. Fertig.
Nur hatte es einen kleinen Schönheitsfehler.
Die Änderungen existierten überhaupt nicht.
Codex bemerkte das beim Review. Eine anschließende Prüfung der Dateien bestätigte es.
Und als der Agent selbst noch einmal nachsah, räumte er ein, dass er die Änderungen zwar beschrieben, aber gar nicht umgesetzt hatte.
Das muss man sich einmal vorstellen.
Da sitzt eine KI und berichtet detailliert über ihre erledigte Arbeit.
Und die Arbeit hat nie stattgefunden.
Ich weiß nicht, ob ich darüber lachen oder weinen soll.
Vermutlich beides.
Das eigentlich Beunruhigende ist aber etwas anderes: Hätte ich nur den Abschlussbericht gelesen, wäre mir der Fehler möglicherweise nicht aufgefallen.
Und genau deshalb reicht es mir inzwischen nicht mehr, wenn eine KI behauptet, etwas erledigt zu haben.
Ich will sehen, was tatsächlich passiert ist.
Wer kontrolliert eigentlich den Kontrolleur?
Natürlich wäre es schön, wenn ich einfach mehrere Modelle zusammenarbeiten lassen könnte.
Big Pickle entwickelt. Codex prüft. Vielleicht noch GLM als zusätzliche unabhängige Instanz.
Klingt nach einem vernünftigen Team.
Dumm nur, dass auch Reviewer Fehler machen.
Bei einem Versuch mit GLM hatten wir absichtlich einen Fehler eingebaut.
Der Reviewer sollte ihn finden.
Hat er nicht.
Damit war meine Vorstellung vom automatisch funktionierenden KI-Entwicklerteam endgültig etwas ramponiert.
Denn offenbar reicht es nicht, eine zweite KI auf die erste loszulassen.
Die zweite kann genauso danebenliegen.
Und wenn beide sich einig sind, bedeutet das noch lange nicht, dass sie recht haben.
Zwei KI-Modelle können sich schließlich auch gemeinsam irren.
Und da wurde es spannend.
Kostenlos ist nicht umsonst. Und unabhängig schon gar nicht.
Inzwischen sehe ich meine ursprüngliche Idee etwas nüchterner.
Lokale Modelle sind faszinierend. Sie laufen auf meiner Hardware, und ich muss meinen Code nicht zwangsläufig irgendwohin übertragen.
Dafür brauche ich ausreichend Rechenleistung und gelegentlich eine bemerkenswerte Leidensfähigkeit.
Kostenlose Cloud-Modelle können deutlich mehr Leistung bieten.
Aber ich bin von deren Verfügbarkeit, Nutzungsbedingungen und Kontingenten abhängig. Und kostenlos heute heißt nicht unbedingt kostenlos morgen.
Vor allem habe ich festgestellt, dass die Modelle selbst nur die halbe Geschichte sind.
Die eigentliche Herausforderung ist ihre Zusammenarbeit.
Wer bekommt welche Aufgabe? Wer kontrolliert das Ergebnis? Wer erkennt, wenn etwas schiefgeht? Und wer entscheidet am Ende, ob eine Änderung tatsächlich übernommen wird?
Ich dachte ursprünglich, ich müsste nur die richtigen Modelle finden.
Heute glaube ich, dass ich vor allem die richtige Arbeitsweise finden muss.
Wer sich das Ganze anschauen möchte …
Ich habe die bisherigen Versuche, Erfolge und Fehlschläge in meinem Local Agent Lab dokumentiert.
Dort gibt es auch die Ergebnisse, die nicht besonders schmeichelhaft ausgefallen sind.
👉 https://lab-cbrown.github.io/local-agent-lab/
Das Lab ist noch im Aufbau. Und genau das gehört zur Geschichte. Ich will nicht zeigen, wie toll KI angeblich schon alles kann, sondern herausfinden, was tatsächlich funktioniert.
Und was eben nicht.
Was davon hängen bleibt
Ich wollte ein kostenloses KI-Entwicklerteam aufbauen, das mir Arbeit abnimmt.
Inzwischen habe ich einige erstaunlich fähige Mitarbeiter. Einer programmiert ordentlich, ein anderer braucht drei Anläufe, und gelegentlich erklärt mir einer stolz, er sei fertig, obwohl er noch gar nicht angefangen hat.
Klingt eigentlich schon ziemlich nach einem normalen Team.
Nur mit dem Unterschied, dass ich bei KI noch viel genauer hinschauen muss, ob das, was sie behauptet, auch tatsächlich stimmt.
Was mich dabei am meisten überrascht hat, ist nicht, wie viel diese Modelle bereits können.
Sondern wie wenig ihre Fähigkeiten allein über die Qualität des Ergebnisses aussagen.
Ein gutes Modell ersetzt keinen guten Entwicklungsprozess. Und ein zweites Modell ersetzt nicht automatisch die Qualitätskontrolle.
Ich werde also weiter ausprobieren, testen und vermutlich noch öfter über irgendwelche KI-Kollegen den Kopf schütteln.
Aber mein Ziel hat sich verändert.
Ich suche nicht mehr die eine KI, der ich blind vertrauen kann. Ich möchte eine Zusammenarbeit aufbauen, bei der ich keiner einzelnen KI blind vertrauen muss.
Das klingt weniger spektakulär als ein vollständig autonomes Entwicklerteam.
Ist aber vermutlich deutlich näher an dem, was wir wirklich brauchen.
Und wenn ich dafür noch ein paar Runden PowerShell-Bingo spielen muss, dann ist das eben so.
Fortsetzung ziemlich sicher. Leider auch die Fehlermeldungen.

Das könnte dich ebenfalls interessieren
Nicht unmenschlich. Sondern erschreckend vertraut.

Human in the Loop reicht nicht!